CASE STUDY 01 · DATA PRODUCT
把公开信息研究,
做成可追溯的数据产品。
一句话结论
把分散在政策文件、企业动态与行业报道里的公开信息,沉淀为 361 条可溯源证据、 210 个主体档案与 12 条行动候选——研究第一次可以被复核、被复用,并被直接拿去讨论合作。
问题 / 背景
- 产业合作拓展中,信息分散在政策文件、企业动态与行业报道里,没有统一的证据口径;
- 传统行业研究以一次性报告为出口:结论难以复核,更难直接转化为下一步业务动作;
- 真正需要的不是「更多信息」,而是一个证据可回溯、主体可索引、行动可跟进的数据产品。
定位:线索雷达,而非企业尽调
- 信息库服务的是业务拓展:每个主体要回答「跟业务方有什么关系、场景是什么、门从哪进、下一步做什么」;
- 字段有明确的价值观排序:线索字段(本地落点、服务场景、公开业务入口)是核心,资质字段(维修 / 回收 / 检测资质)重要,背景字段够用即可;
- 产能、股权结构、营收等尽调字段刻意不追——遇到则记,缺了不补;
- 招采公告、项目启动、网点开业等「动态类」信息不是水分,而是代表切入时机的高价值线索信号。
L1–L4 来源分级与三条护栏
- L1
- 官方原文(政府 / 企业官网 / 交易所披露)——任何字段可用
- L2
- 官方平台转引——任何字段可用
- L3
- 第三方整理 / 新闻——正式入库,标「待回链」;动态与线索类字段可直接使用
- L4
- 检索留痕——过程记录,不算事实
- 等级门槛:资质、中标结果、合作关系等硬字段至少 L2,L3 只标「待回链」进队列;
- 自动回链:L3 事实入库时自动生成回链核验任务,攒批处理;
- 冲突覆盖:L1/L2 与 L3 矛盾时以高等级为准并修订,更正全程留痕。
为什么放宽到 L3:线索的价值在时机,等官方原文可能错过招采报名窗口—— L3 当时机信号、L1/L2 做硬事实确认,是线索型库的正确分工。
数据产品工作流
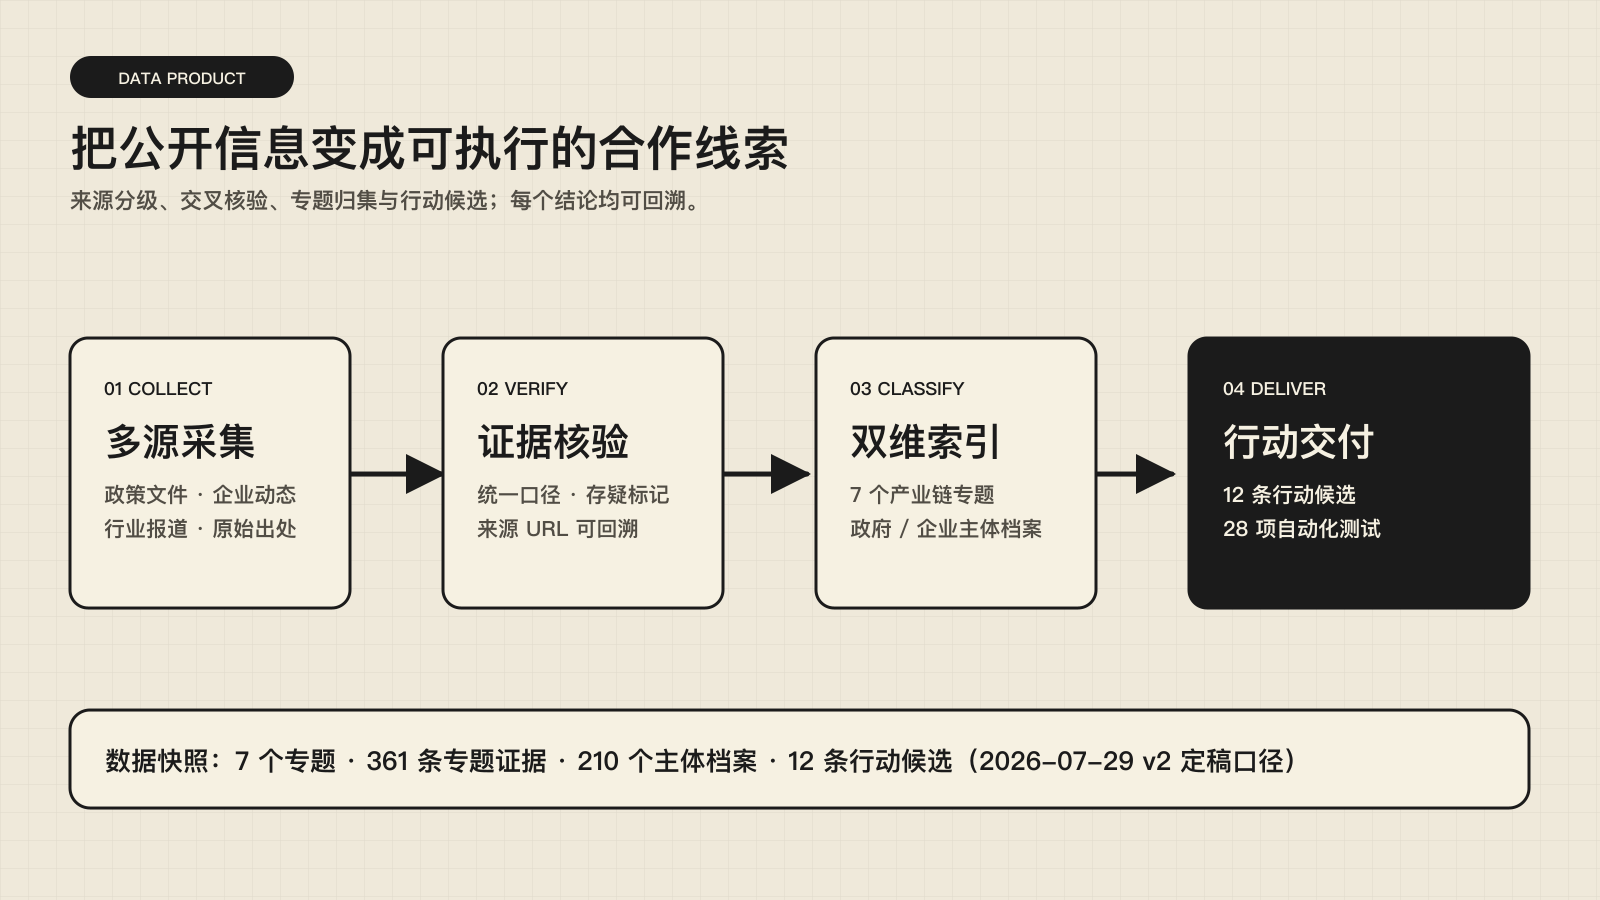
- 来源分级:L1–L4 全收分级(见上节),每条证据保留原始出处 URL;
- 证据核验:统一事实口径,存疑信息进入「待判定与降级清单」,不混入定稿;
- 双维索引:产业链 7 个专题 × 政府/企业主体档案,任何一条证据都能双向定位;
- 行动交付:出口不是报告,而是行动候选清单与可持续更新的工作簿。
7 个专题 × 361 条证据
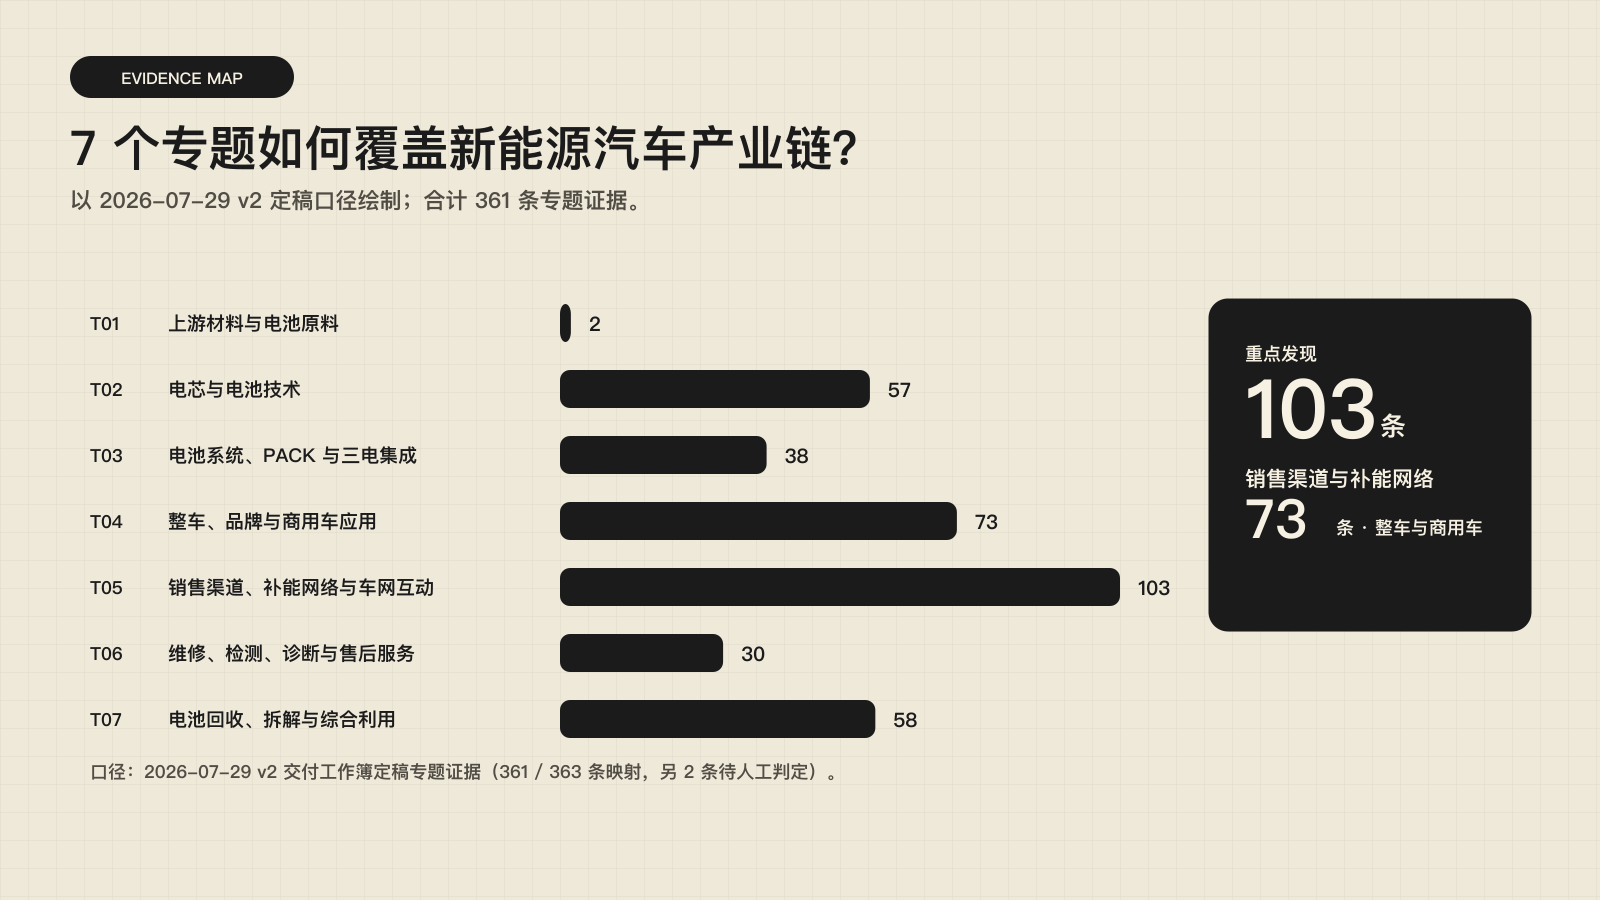
- T01 上游材料与电池原料 · 2 条
- T02 电芯与电池技术 · 57 条
- T03 电池系统与三电集成 · 38 条
- T04 整车与商用车应用 · 73 条
- T05 销售渠道与补能网络 · 103 条
- T06 维修检测与售后服务 · 30 条
- T07 电池回收与综合利用 · 58 条
分布本身就是研究结论:证据向「销售补能」与「整车应用」集中,上游材料仅 2 条—— 广度筛选之后,跟进资源应投向产业链中下游。
15 表工作簿结构
- 口径层
- 说明与口径 · 专题总览(7 专题 × 全国/区域两线)
- 证据层
- T01–T07 专题证据表(信息类别 / 主体 / 事实摘要 / 来源 URL / 证据 ID)
- 主体层
- 主体档案与字段覆盖(210 个主体,含待采字段清单)· 公开联系方式
- 治理层
- 来源与核验台账 · 待判定与降级清单 · 每周资讯 · 政府招投标
口径:2026-07-29 v2 定稿——专题证据 361 条(映射 363 条,另 2 条待人工判定)、 主体档案 210 个、行动候选 12 条;另有行动候选工作簿独立成册。
工程与质量
- 数据生产线由 34 个脚本组成:采集、抽取、分类、导出各环节独立可复跑;
- launchd 周更自动化:信息库按周增量更新,而不是一次性交付后过时;
- 全套自动化测试随每次导出运行,通过后方可交付;
- 每个版本附 release manifest:记录条数口径、对账结果与测试状态,版本间可 diff。
边界与说明
- 全部内容来自公开信息,不涉及任何企业内部数据;
- 证据为「已披露事实」的结构化整理,不代表对相关企业商业前景的判断;
- 行动候选是研究建议,落地需结合业务方进一步尽调。